扫 10 万个文件时,别让一个进程扛到死
扫 10 万个文件时,别让一个进程扛到死 看见扫描器卡死在共享盘上,我第一反应是:线程不够,该上 Redis。答案是:并发方向没完全错,但进程先死掉的地方,通常不是队列装不下。 一台扫描仪整晚往共享目录里吐 PDF。 早上打开资源管理器,文件夹已经堆满了。你写过一个很老实的脚本: 二十个文件时,它能跑完。 这一次不一样。任务管理器里那个 Python 进程还
看见扫描器卡死在共享盘上,我第一反应是:线程不够,该上 Redis。答案是:并发方向没完全错,但进程先死掉的地方,通常不是队列装不下。
一台扫描仪整晚往共享目录里吐 PDF。
早上打开资源管理器,文件夹已经堆满了。你写过一个很老实的脚本:
walk 到一个文件
→ 立刻算 SHA-256
→ 立刻抽正文 / OCR
→ 再走下一个
二十个文件时,它能跑完。
这一次不一样。任务管理器里那个 Python 进程还在,CPU 却不怎么动。目录还在往下钻,哈希卡在一份刚拷进来的大 PDF 上,OCR 还没轮到后面那一摞。共享盘延迟、文件锁、内存占用叠在一起,进程看起来像死了。
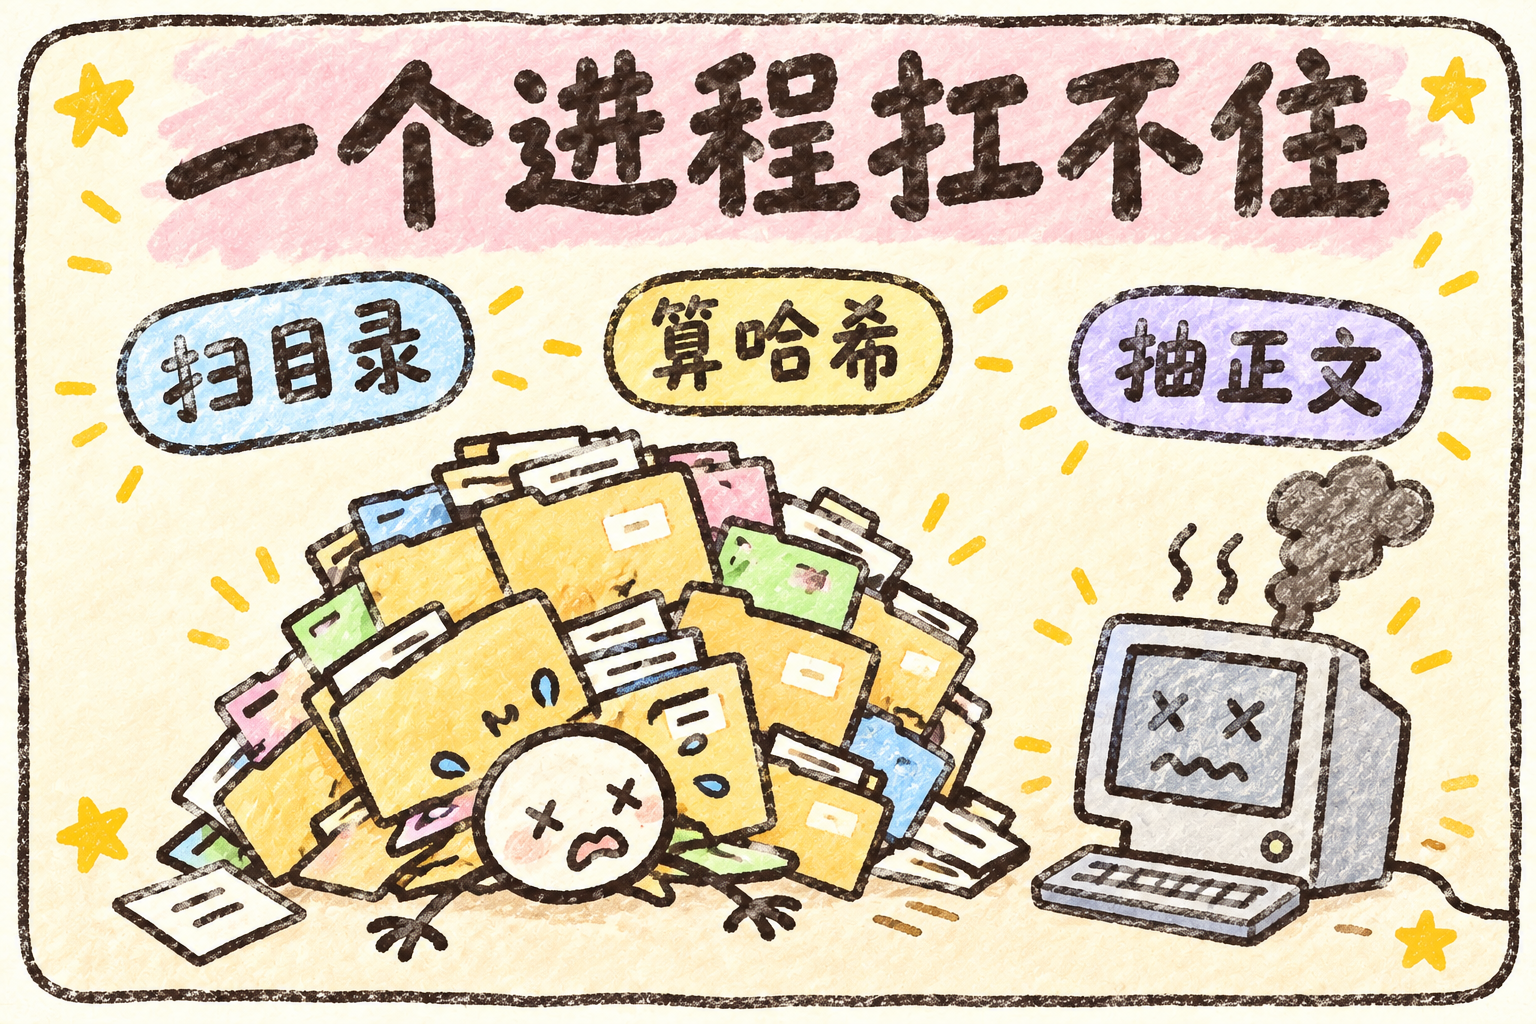
更糟的是,它其实没死。它在认真处理一份还没写完的文件。
对面还在往这个名字里灌字节。你这边已经打开了,哈希算完,正文也抽了。过几秒拷完,大小变了。索引里留下一页残字。检索一搜,命中的是半截合同。
这个场面很容易触发一个熟悉的判断:
开多线程,上 Redis,上 Celery,不就好了?
这个判断不能说完全错。消化确实太慢,多几个 Worker 能把 OCR 拉开。
但如果直接翻译成「队列装得下就完事」,后面三件事会越来越别扭:文件还在写你已经开始读;每次全量都把没改过的文件重哈希一遍;进程一杀,进度跟着内存一起没了。
更准确的说法是:
发现和消化要拆开;任务要落盘;文件还在写就先别读;新旧先看 size 和 mtime。
这篇就从这句话展开。
#01 找的人和吃的人分开
一个进程既要遍历目录,又要读文件内容,这两件事的速度差了一个数量级。
os.walk 很快。共享盘上算哈希很慢。OCR 更慢。
边走边处理,发现会被消化拖死。反过来,先把几万条路径一次性塞进内存,消化还没开始,进程也可能先爆。
该拆的是这两条线:
发现
  只登记:路径、扩展名、大小、修改时间
        ↓
任务表
        ↓
Worker
  再去哈希、抽正文、登记失败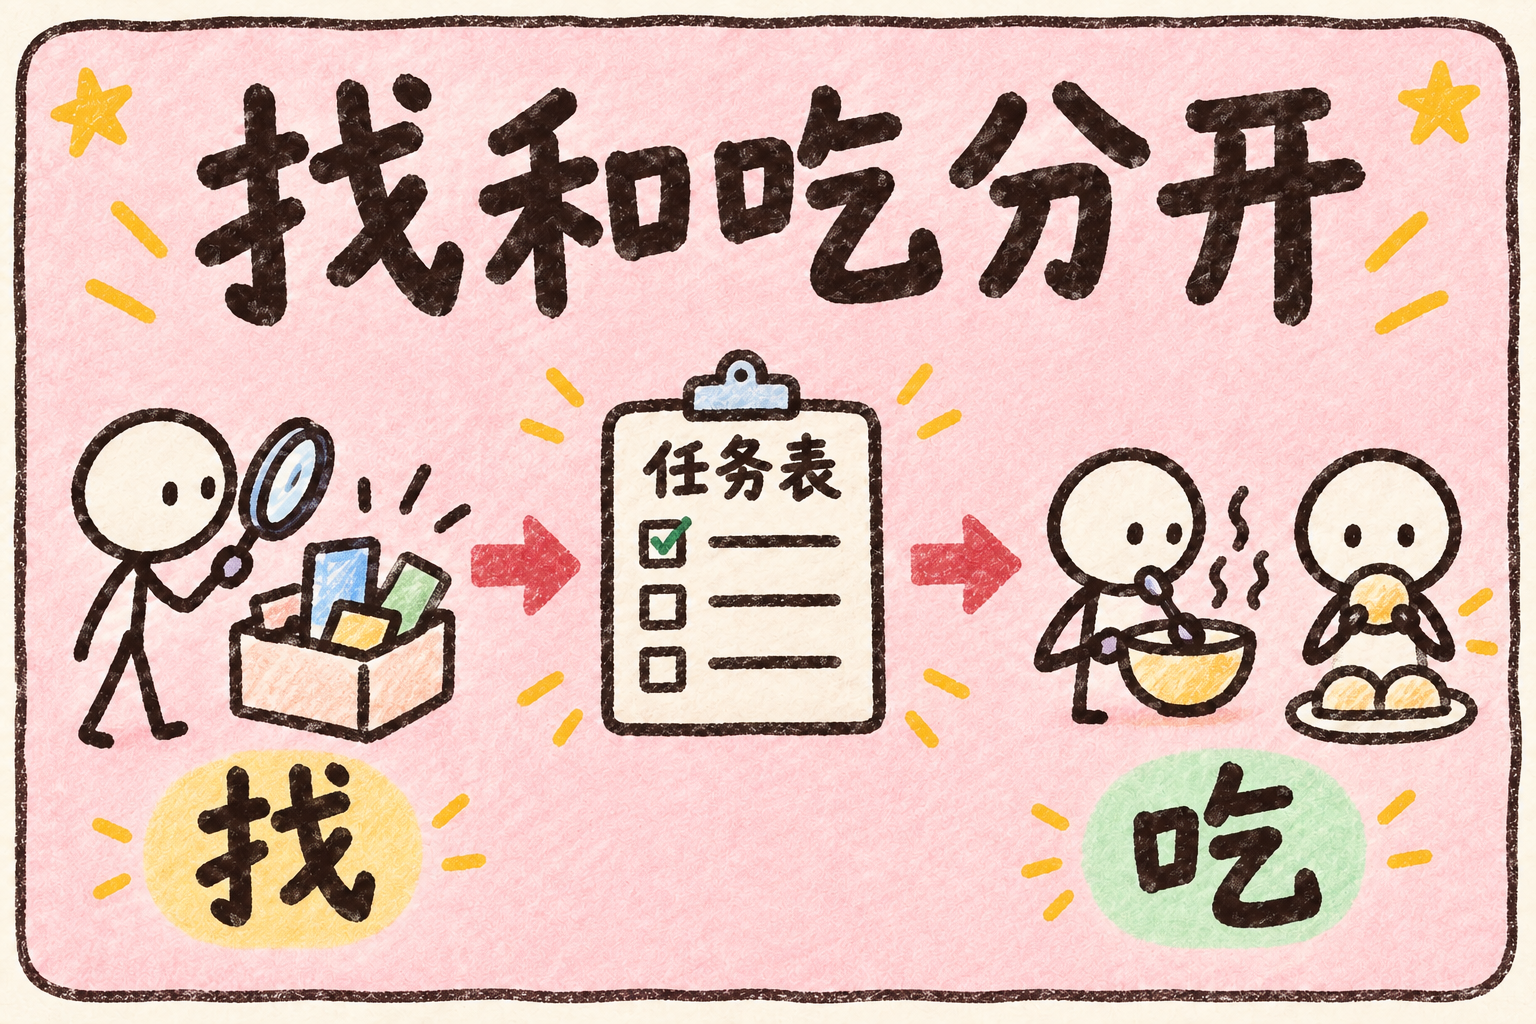
发现端不读内容。Worker 不负责把整棵目录树装进内存。
Paperless-ngx 把这件事写得很直白。官方文档说,看着消费目录的那个进程,其实并不真正消费文件;它只是通知任务处理器「有新文件了」。OCR 是 Celery 干的。文档自己都说:这个组件也许该换个名字。[1]
名字换不换无所谓。关键是这两件事不能绑在同一个循环里。
发现还得能停。生成器逐项 yield,积压过了阈值,发现端就睡一会儿,等 Worker 把水位打下去。这叫反压。不是为了架构图好看,是因为发现远快于消化。不挡住上游,下游会被自己的待办淹死。
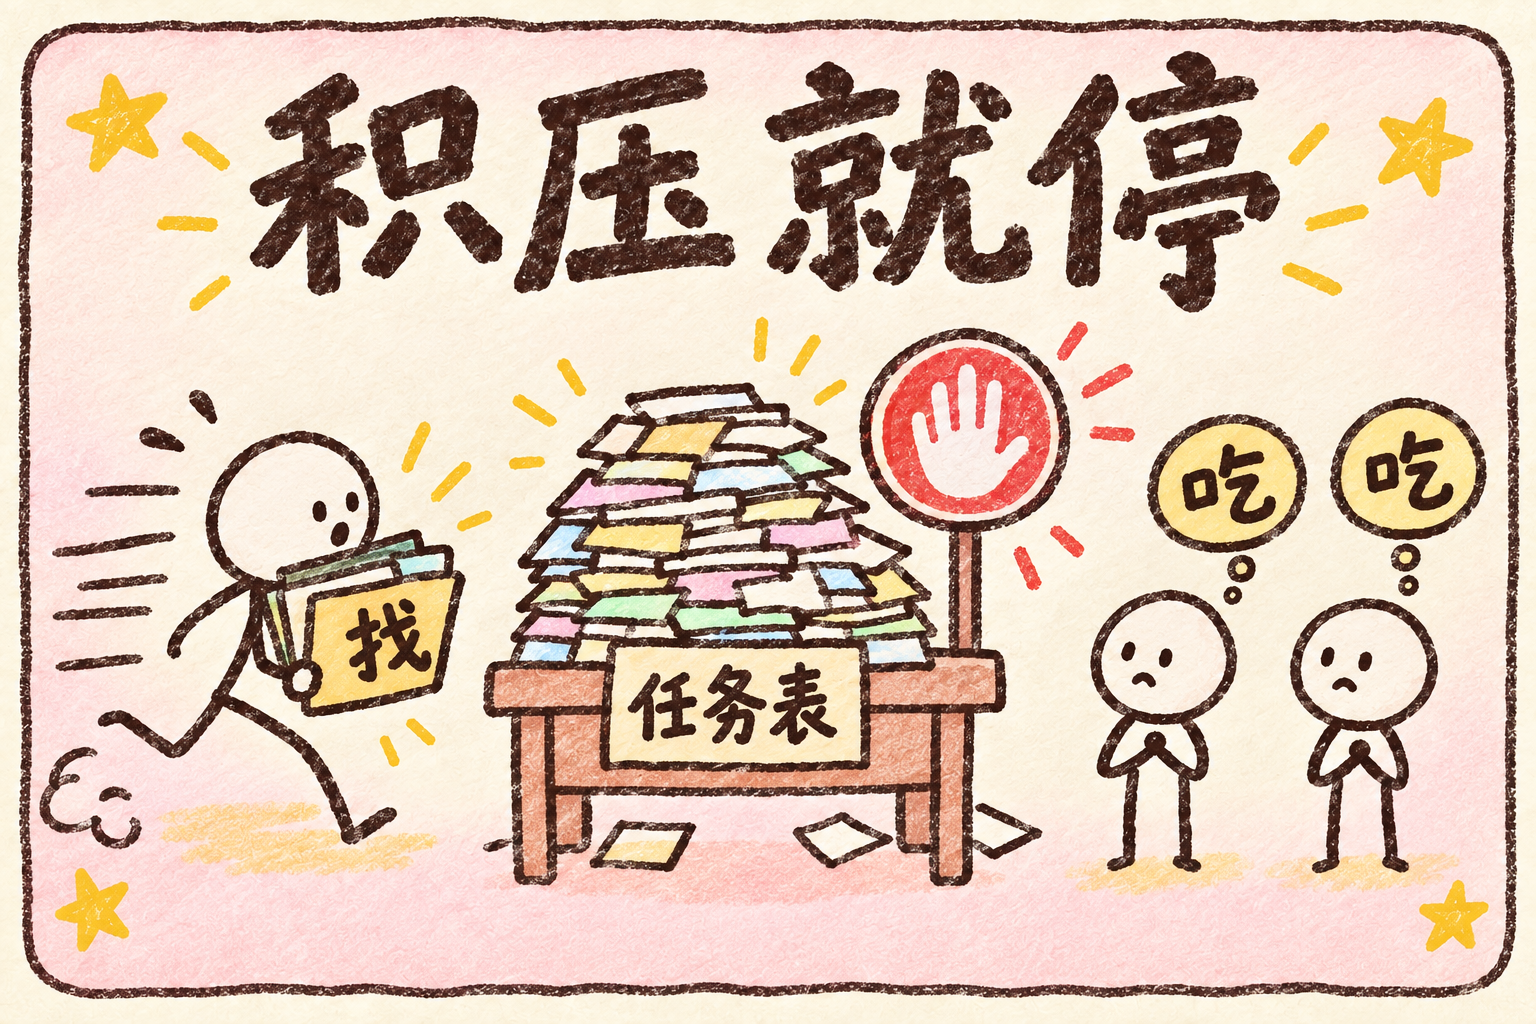
Worker 可以是 1 个。机器和磁盘够,再开到 2~4 个。
一上多人,就必须有一张任务表。内存列表做不到「谁领了哪条、领完没交回去」。Redis 能做,SQLite 也能做。选哪一种,取决于你能不能接受「哈希期间一直占着库锁」。
领任务必须短:
BEGIN IMMEDIATE
领一条 ready
标成处理中
写下到期时间
立刻 COMMIT
哈希和 OCR 在锁外面做。否则一份厚 PDF 就能把整张表卡住。
票领到手,锁马上还。后面那本文件在旁边慢慢啃,别抱着整张表不放。
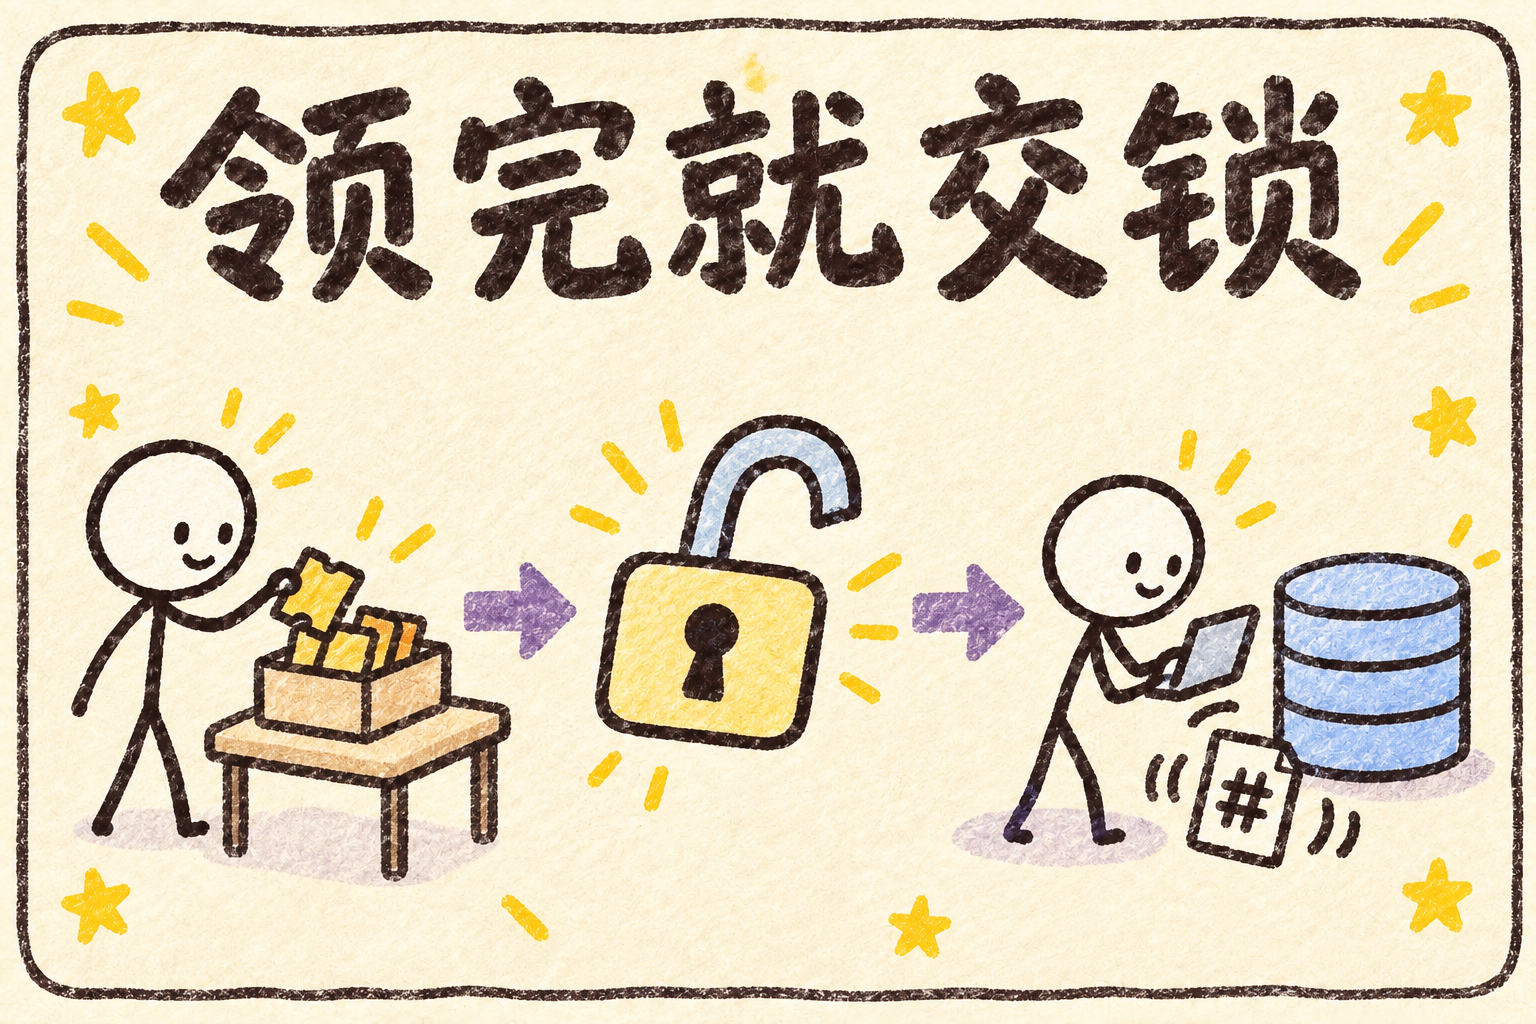
领取顺序也有偏向:新文件优先,同样新则小文件优先。先铺开能检索的覆盖,大视频后啃。状态页如果只显示「文件完成率」,会被小文件骗得很乐观。字节完成率也要看。
#02 别拿到半成品
共享盘上最常见的事故,不是文件不存在,是文件还在写。
开头那个场面里,脚本其实「成功」处理了文件。它打开了,读完了,写入索引了。错的是时机:对面还没写完。
处理办法不神秘:先确认它写完了,再读。
记下当前 size、mtime
等 1~2 秒(可配)
再看一次
对不上 → 先放回等待,不要哈希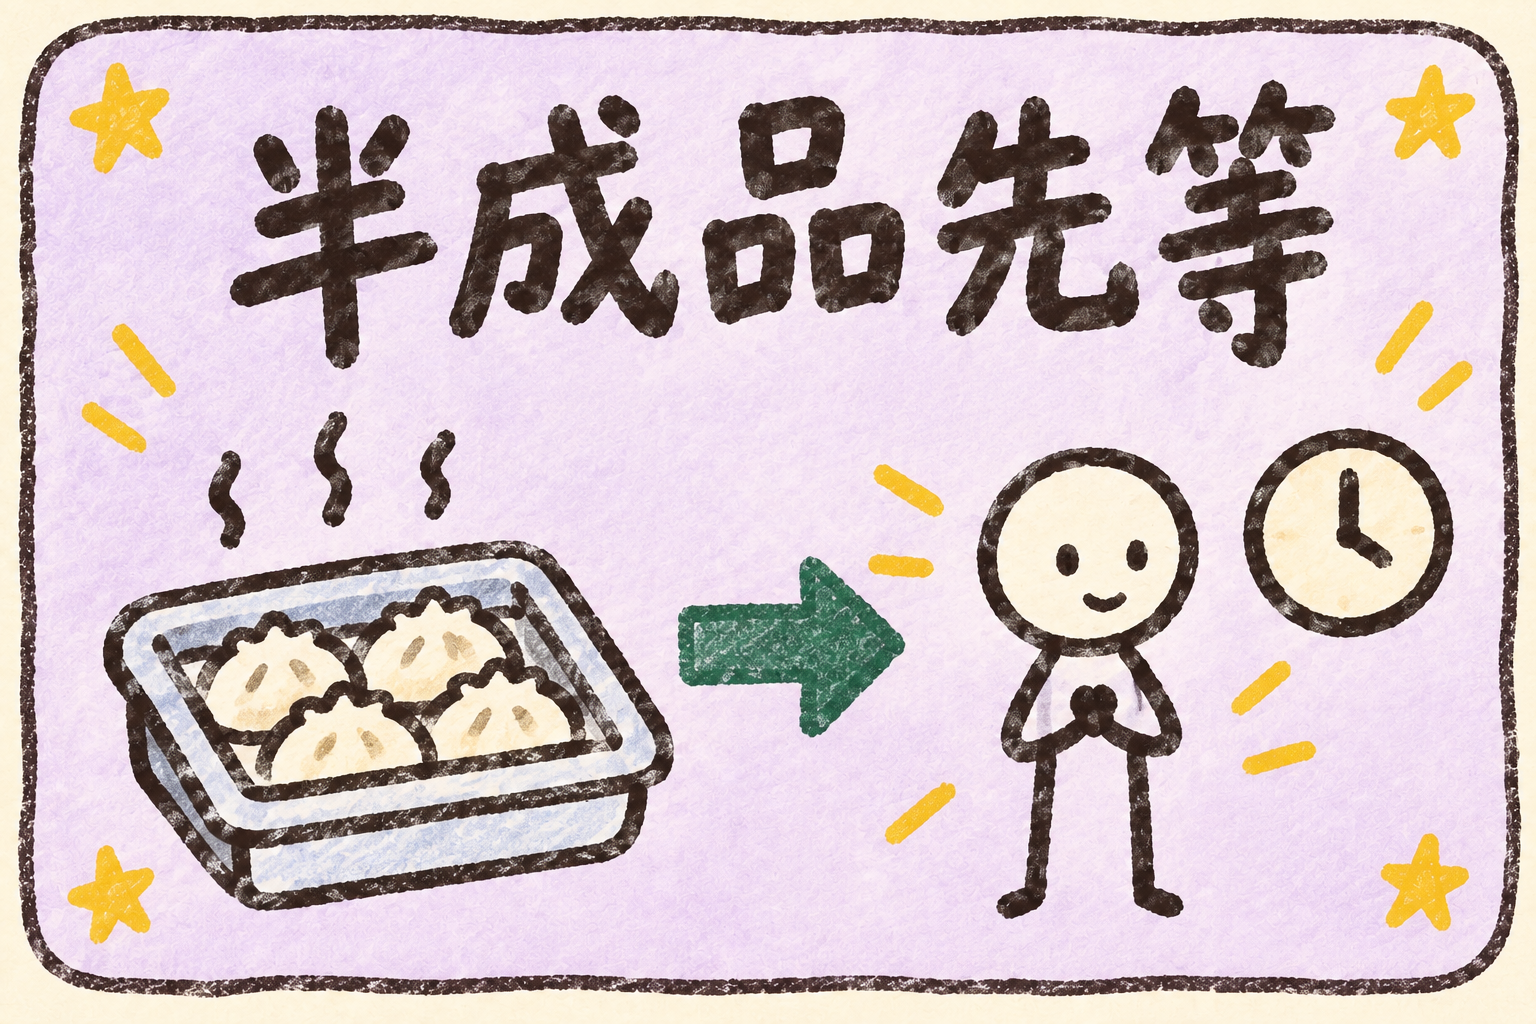
Paperless 的消费目录就踩过这个坑。官方排障里有两行很具体的日志:
Timeout while waiting on file ... to remain unmodified.
OS reports file as busy still
意思是:文件还在往目录里写,消费端已经上手了。NFS 这类没有 inotify 的盘,还得改成轮询;轮询时连续两次 size 和 mtime 都不变,才当成写完。[2][3]
Windows 上还可以多试一次只读打开。对面还握着写锁,打开会失败,直接当不稳定。
不稳定的文件不要卡死整轮。标成「平复中」,过几秒再领。扫描器继续吃别的稳定文件。对正在拷贝的共享盘,这两秒不要省。
#03 判断新旧,别每次先算哈希
哈希是完整读盘。共享盘上几十上百 GB,每次全量重算,时间和带宽都付不起。
处理完一个文件,把两样东西记下来:
size
mtime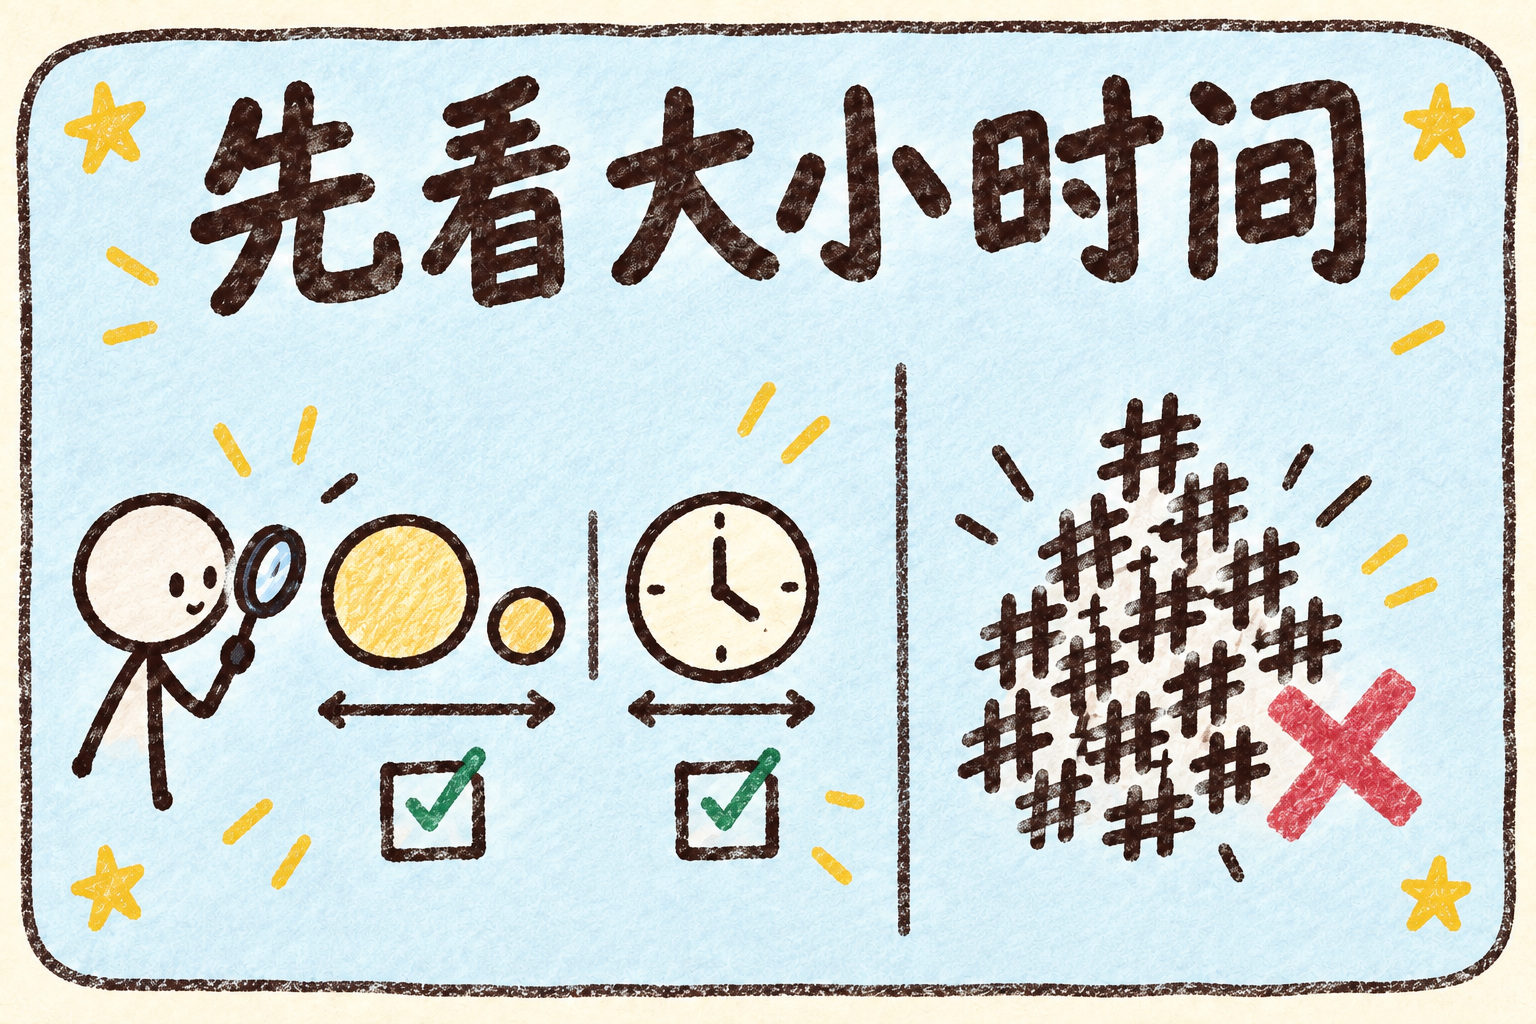
下一轮发现时,先比这两项。都没变,认定文件没动,不打开,不算哈希,不抽正文。
rsync 默认就是这么干的。手册把这套叫 quick check:先看大小和最后修改时间,对得上就跳过。只有加 --checksum,才会改成按校验和决定要不要传。[4]
Git 更早做成了索引。工作区文件一多,git status 不能每个文件都读一遍内容。索引里缓存了 lstat 的结果,先比类型、mtime、size;对得上,就当没改。[5]
只记修改时间也能用。拷贝工具却经常「碰一下时间戳、内容没变」,或者反过来「内容变了、时间被写回去」。两个都记,误判会少很多。
mtime 变了再算哈希。哈希相同,只刷新时间戳,正文继续用。哈希不同,才重新抽取。
旧索引如果没有这两列,就退回重算哈希。这是兼容,不是默认路径。
跳过也不是没干活。它是「比过了,沿用旧正文」。大小和时间对得上,文件夹都不用打开,这轮仍然算处理完。
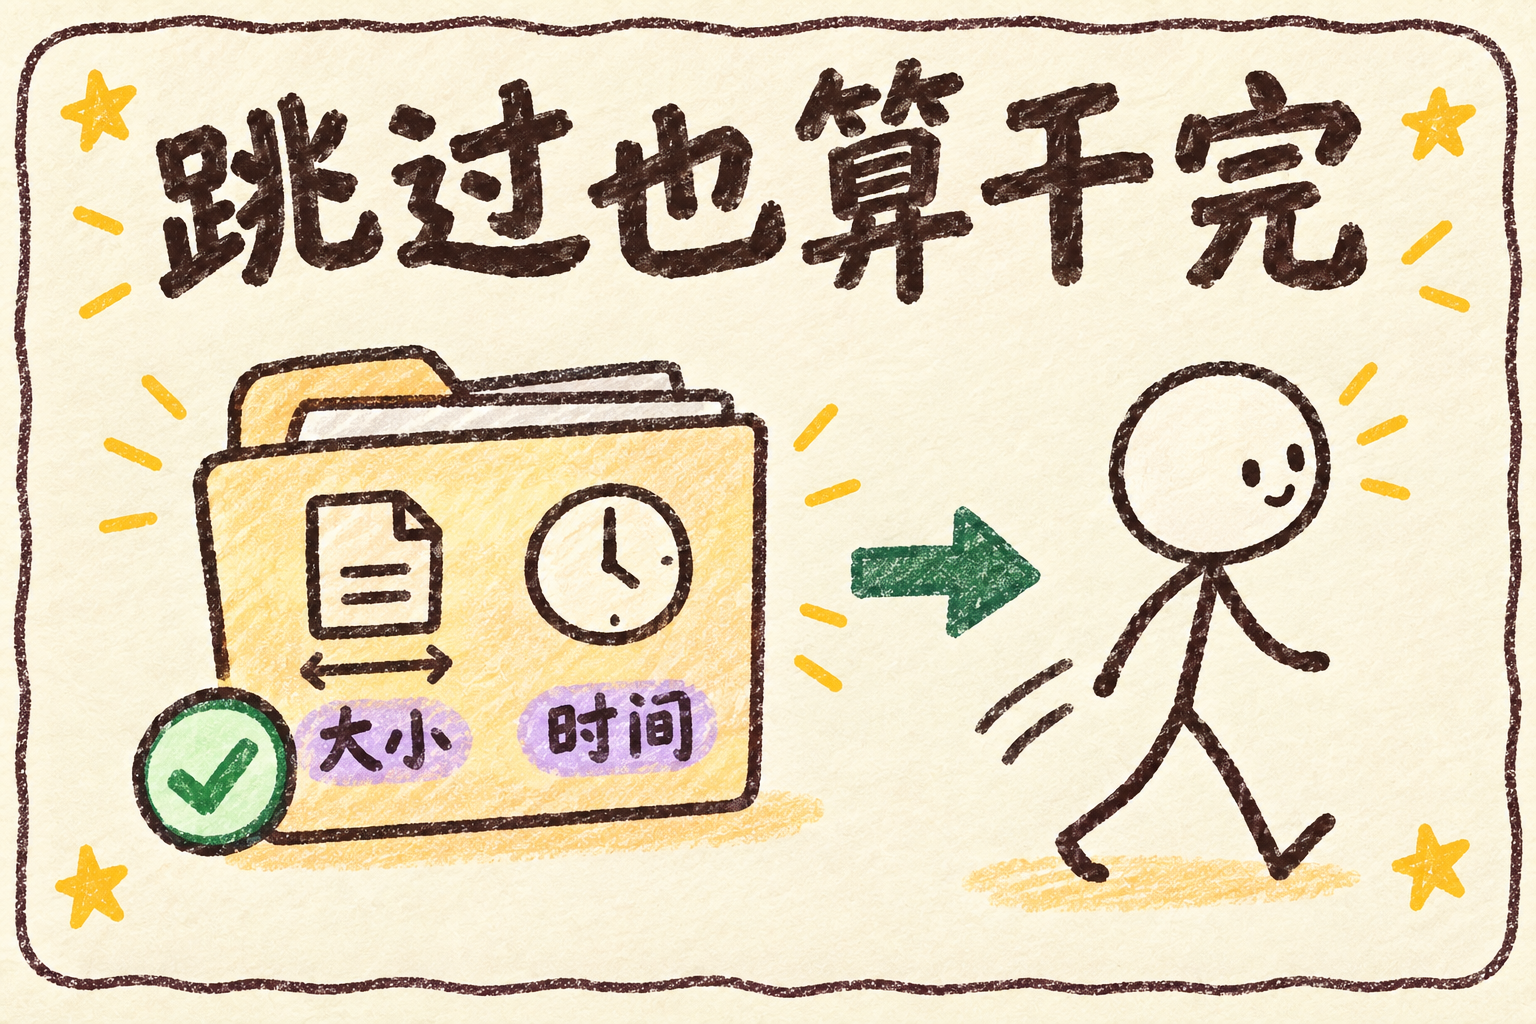
所以「全量扫描」保证的是目录账对齐:该发现的都登记了。它不等于每个字节重读一遍。没改过的办公文档,大多数应该在 size + mtime 这一层被跳过。
Git 也承认这套启发式会翻车:改文件太快、mtime 没变,索引会误判干净。官方叫 racy-git。补救不是放弃 stat 缓存,而是对「可能有竞态」的那几条再比一次内容。[5]
#04 断了接着跑
进度只放在内存里,杀进程就没了。下一次只能重新 walk,靠猜才知道做到哪。
任务状态要落盘。SQLite、Redis、文件都行,关键是进程没了数据还在。
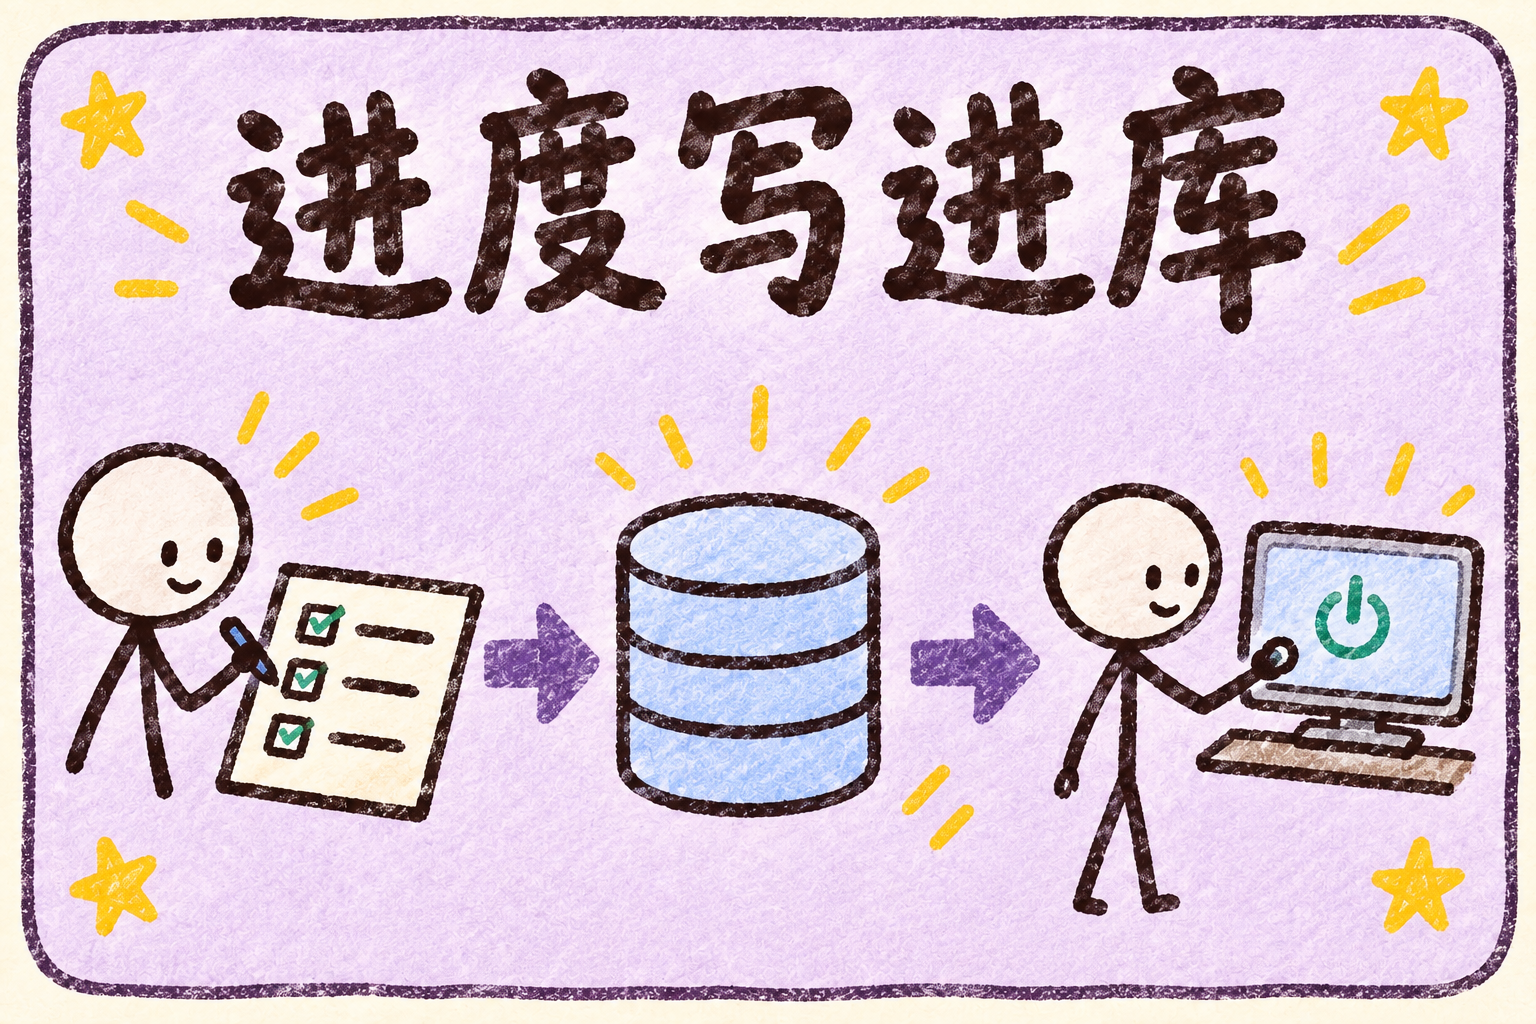
够用的状态并不多:
ready        等领取
settling     还在写,晚点再看
hashing      有人正在处理
done         抽完或只登记
skipped      判断过了,沿用旧结果
failed       出错,稍后重试
blocked      重试满了,别再自动跑
处理中要加租约。进程死了,租约过期,下一次启动把这些任务打回 ready。换个 Worker 再领,不要永远停在「处理中」。
Celery 默认是任务一开始就 ack,worker 挂了这条不会重投。想让崩溃后还能被别人捡起来,得开 acks_late:做完再确认。用 Redis 当 broker 时,还有 visibility timeout,默认一小时;超时没 ack,消息会重新可见。大文件如果超过这个窗口,会变成重复做。[6][7]
领任务
→ 写下到期时间
→ 在锁外面慢慢干
→ 干完再确认
超时没确认 → 别人捡起来
票上的钟过了,原来那个人消失了,下一个人把同一张票捡起来。进度在表里,不在那个已经没了的进程里。
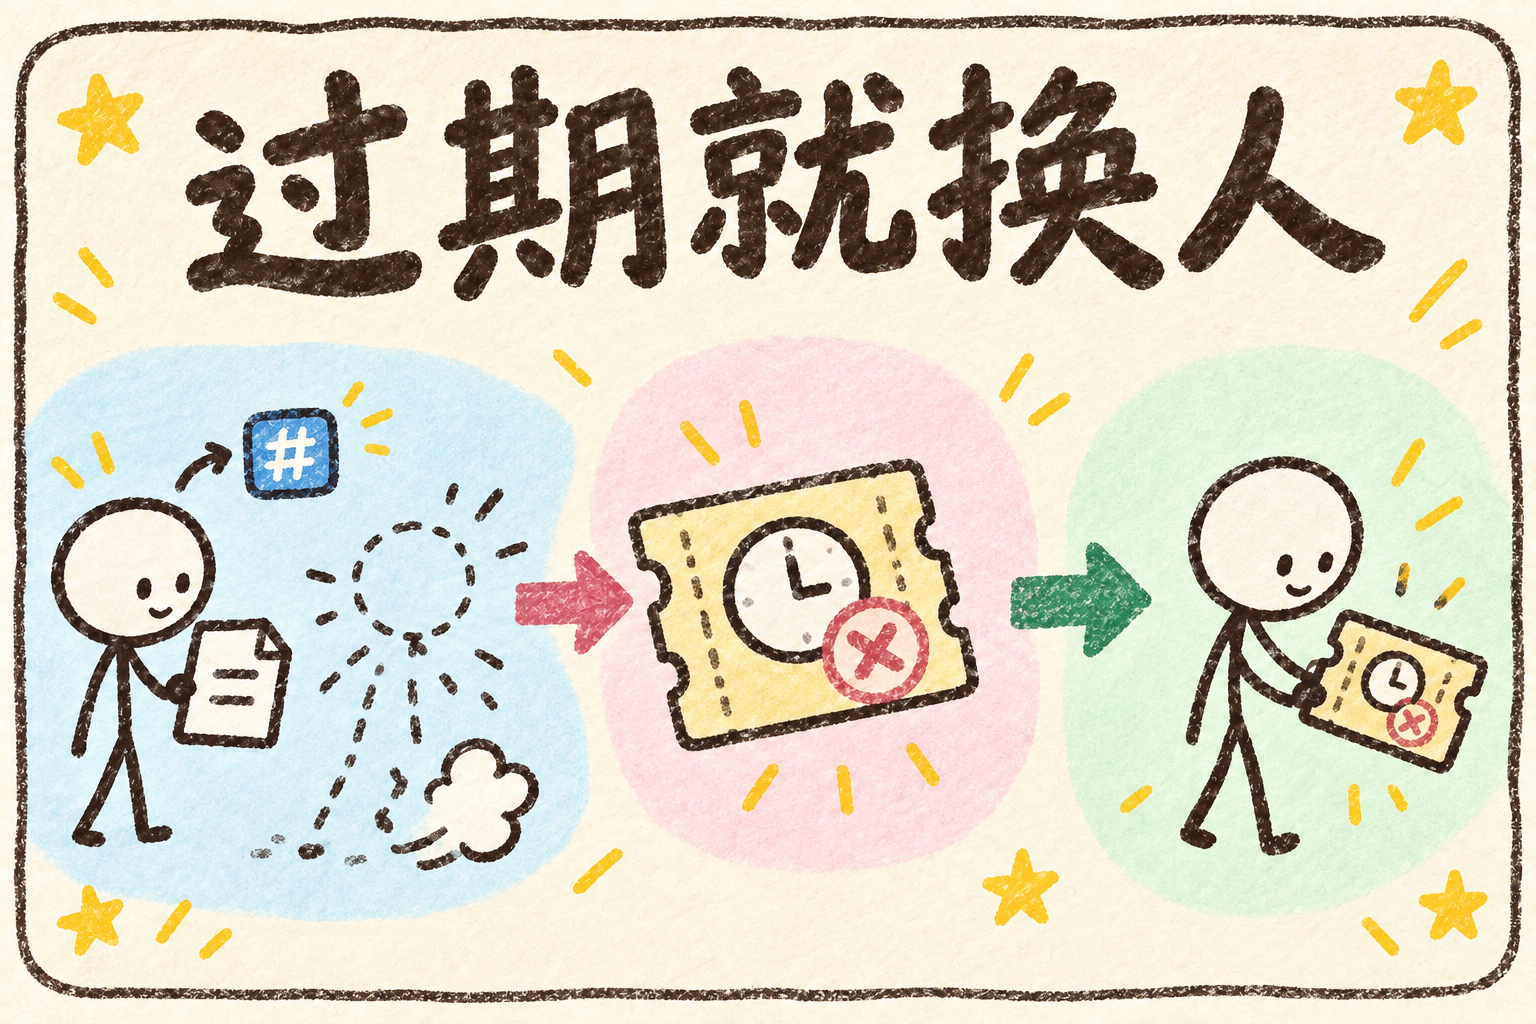
领任务的短事务,和租约是配套的。你不能在哈希期间一直占着库锁,也不能让两个 Worker 长时间抢同一份文件。
大文件有个坑:哈希本身可能超过租约。如果不续租,恢复逻辑会把还在算的任务打回就绪。租约时长要按最大文件和磁盘速度调,不要抄 60 秒或 Celery 那一小时当教条。
下次启动的第一件事不是重新遍历,而是先回收过期租约,再加载上一轮有效记录做指纹对比。目录还是要走,用来发现新文件;已经完成的条目,靠状态接着跑。
#05 这套东西不解决什么
施工和对外检索是两件事。
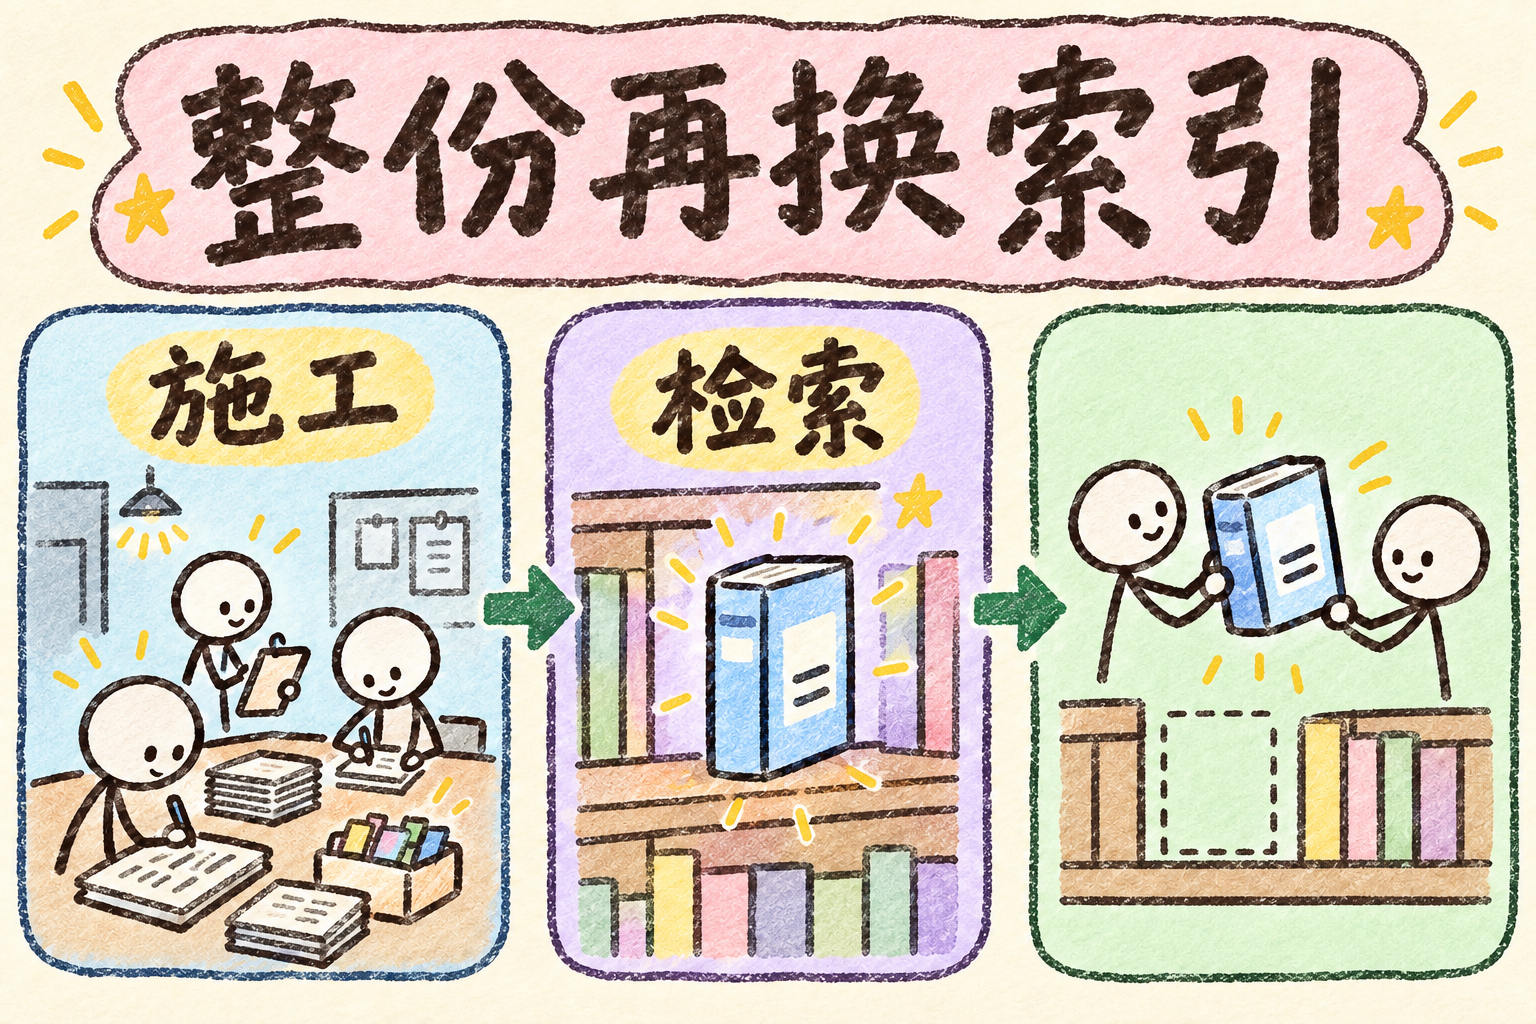
Worker 可以一边写抽出的正文,搜索却仍读上一版整份索引。整轮结束,再用临时文件加原子替换。扫描中途不要让检索看到一半新、一半旧。
施工在后台改笔记,检索只读架上那本完整的书。换的时候整本换,不要一页一页抽。
多 Worker 不是越多越好。SQLite 写锁、共享盘吞吐、磁盘随机读,都会先打满。Paperless 官方排障写过:SQLite 安装开太多 worker,同时消费会把库锁死。[3] 2 个常常比 8 个稳。
稳定性窗口、删除判定,都要显式打开。第一次没扫到文件,先标「疑似丢失」,连续第二次仍未见,才标失效。扫描器不该删用户源文件。网络盘掉线看起来像删除,一次未见就失效,检索会先丢一批不该丢的结果。
「看见文件」和「处理完文件」也不是同一件事。Paperless 自己把 watcher 和 OCR worker 拆开,就是这个意思。[1]
#06 最后,用一句话记住
如果你也在扫共享盘,可以这样记:
发现和消化拆开;任务放进库里;文件还在写就先等;新旧先看大小和时间;断了靠状态续跑。
再具体一点:
找:只登记路径、大小、mtime
吃:哈希、抽正文、失败重试
表:SQLite / Redis / 文件都可以
锁:领完就还,别抱着大文件不放
跳过:size + mtime 对上,就算干完
发布:整份索引原子替换,不让检索读半成品
这些都不是新概念。扫描仪往目录里丢文件时,Paperless 用 Celery 把发现和 OCR 拆开;rsync 默认不每次算校验和;Git 用索引缓存 stat;Celery 用迟到确认加可见性超时做续跑。
大扫描的难点通常不是算法。是发现比消化快,是文件还在写你已经开始读,是进度只活在一个进程的内存里。文件一多、盘还在对端拷的时候,不这么做会先把系统拖死。
#资料来源
- Paperless-ngx Architecture:https://docs.paperless-ngx.com/usage/
- Paperless-ngx Configuration(polling / inotify):https://docs.paperless-ngx.com/configuration/
- Paperless-ngx Troubleshooting:https://docs.paperless-ngx.com/troubleshooting/
- rsync(1) quick check /
--checksum:https://man7.org/linux/man-pages/man1/rsync.1.html - Git racy-git:https://git-scm.com/docs/racy-git
- Celery Tasks(
acks_late):https://docs.celeryq.dev/en/latest/userguide/tasks.html - Celery Redis broker visibility timeout:https://docs.celeryq.dev/en/stable/getting-started/backends-and-brokers/redis.html
内容相关
继续阅读
FastAPI 里的 deps.py,到底是不是 Spring 拦截器?
FastAPI 里的 deps.py,到底是不是 Spring 拦截器? 看见 workflows.py、ai.py、assets.py、tasks.py 都连到 deps.py,我第一反应是:这不就是 Spring 里的拦截器吗?答案是:认证效果有点像,但运行机制不是一回事。 我最近在看一个 Python 后端的知识图。 图里有个很显眼的现象: 几个 AP
使用ThreadLocal实现用户身份认证
使用ThreadLocal实现用户身份认证 什么是ThreadLocal ThreadLocal 是Java语言提供的一种线程局部变量(Thread Local Variables)机制,它可以为每个使用该变量的线程提供一个独立的变量副本。 ThreadLocal 类在java.lang包中,它提供了线程局部变量的功能,这些局部变量与普通的变量不同, Thr

使用注解+反射实现自动填充
使用注解+反射实现自动填充 使用场景介绍 不同操作 需要频繁对 同一个对象 进行相同操作时,可以使用自动填充简化代码,如: 更新或插入一条数据时,需要设置 update time 和 update user ,项目中会有多个业务需要进行插入或更新数据,所有使用自动填充非常合适 前置知识 Spring的面向切片 AOP面向切片编程 mybatis 注解 反射
解决 Spring Session 分布式部署难题:Redis 集成指南
解决 Spring Session 分布式部署难题:Redis 集成指南 🚀 前言:Session 丢失的噩梦 还在为 Spring 原生 Session 无法支持分布式部署而头秃吗?🤯 配合 spring session data redis ,轻松实现 Session 共享:✨ 🛠️ 实现步骤:三步搞定 第一步:引入 Maven 依
评论
还没有评论,来说点什么吧。