废话不多说,直接开源
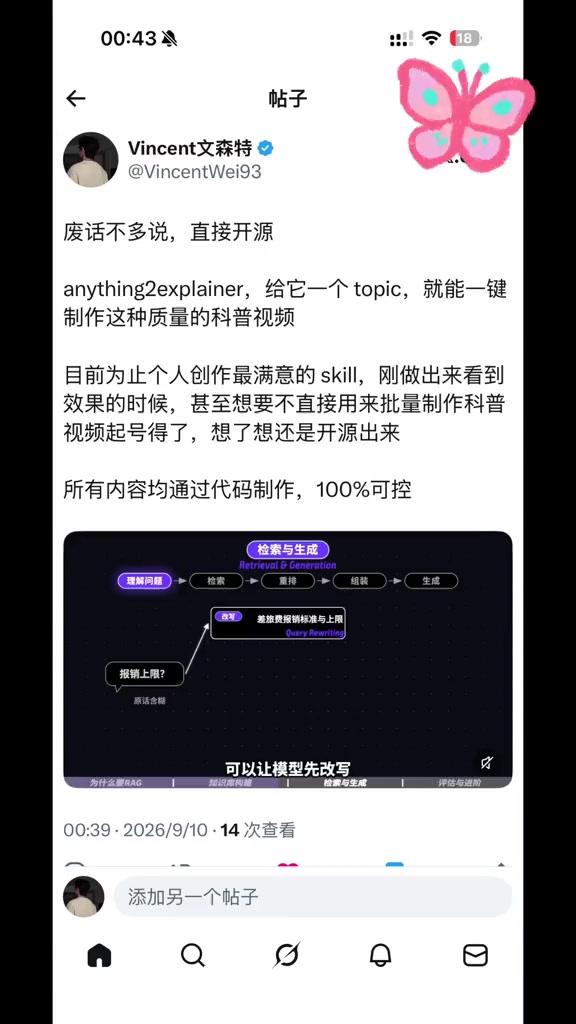
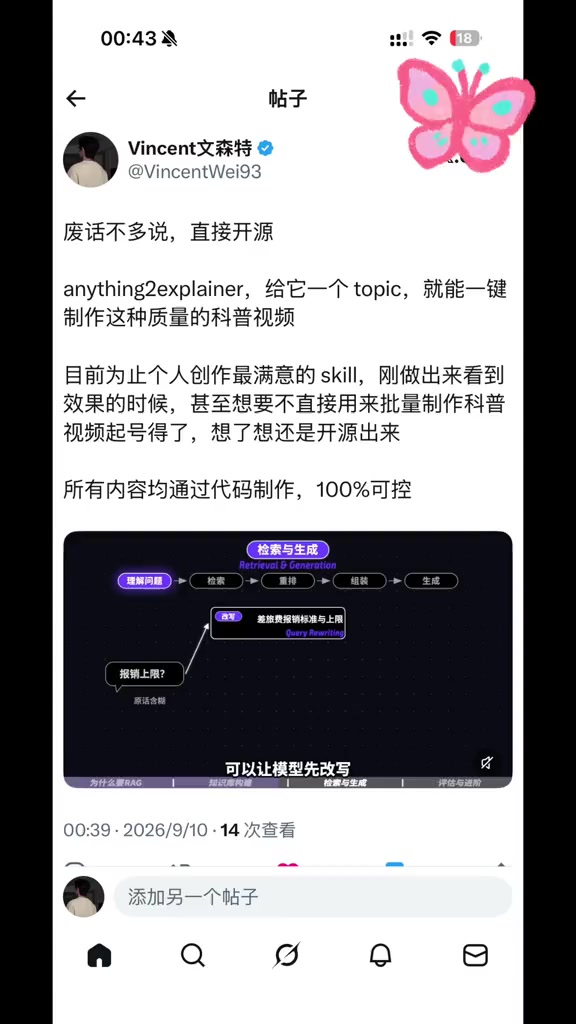
废话不多说,直接开源 来源 原文链接 正文 废话不多说,直接开源 废话不多说,直接开源 anything2explainer :给它一个 topic,就能一键制作这种质量的科普视频。 目前为止个人创作效果最满意的 skill,刚做出来看到效果的时候,甚至想要不直接用来批量制作科普视频起号得了,想了想还是开源出来,可以让所有人学习和研究。 所有内容均通过代码制
#来源
#正文
#废话不多说,直接开源
#废话不多说,直接开源
anything2explainer:给它一个 topic,就能一键制作这种质量的科普视频。
目前为止个人创作效果最满意的 skill,刚做出来看到效果的时候,甚至想要不直接用来批量制作科普视频起号得了,想了想还是开源出来,可以让所有人学习和研究。
所有内容均通过代码制作,100% 可控。
剪辑风格参考 @图灵宇宙 的抖音精选系列推荐系统课程
#AI新星计划 #科普视频 #开源项目 #剪辑教程
#知识库构建 / 检索与生成 / 评估与进阶
整条科普视频的讲解围绕 RAG(Retrieval-Augmented Generation,检索增强生成)这条主线展开,分为三个模块:知识库构建、检索与生成、评估与进阶。
#一、先说结论:大模型很聪明
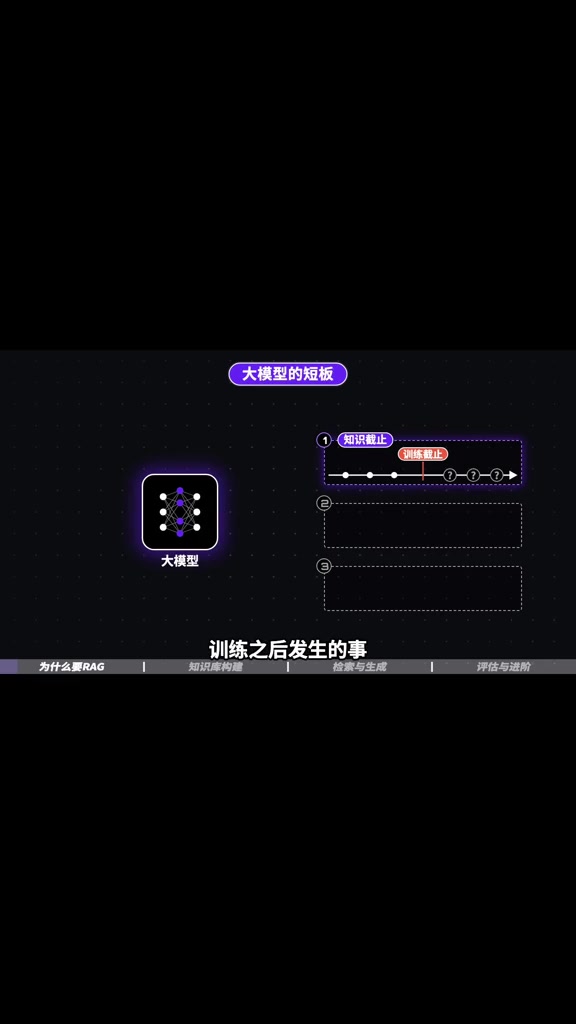
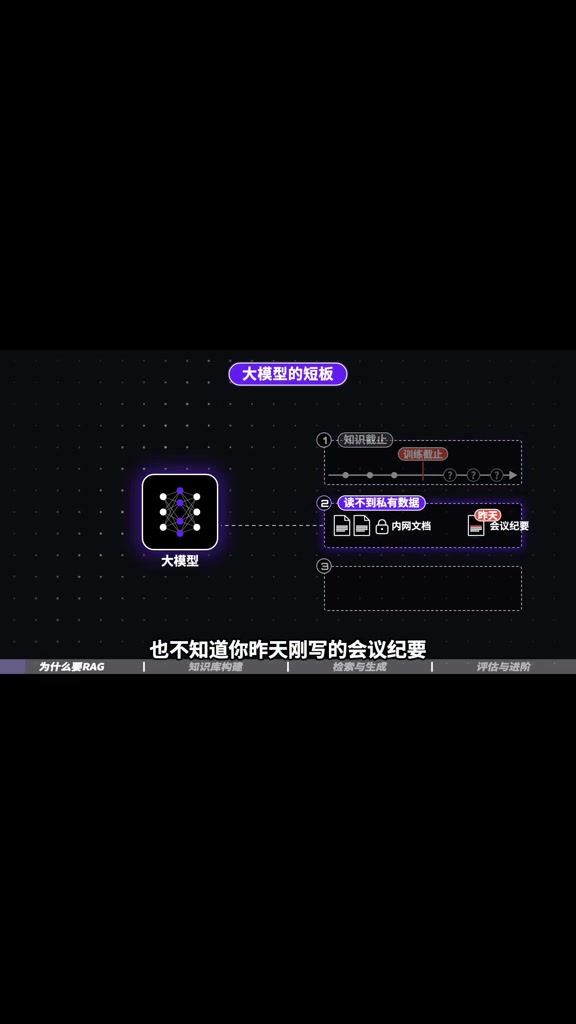
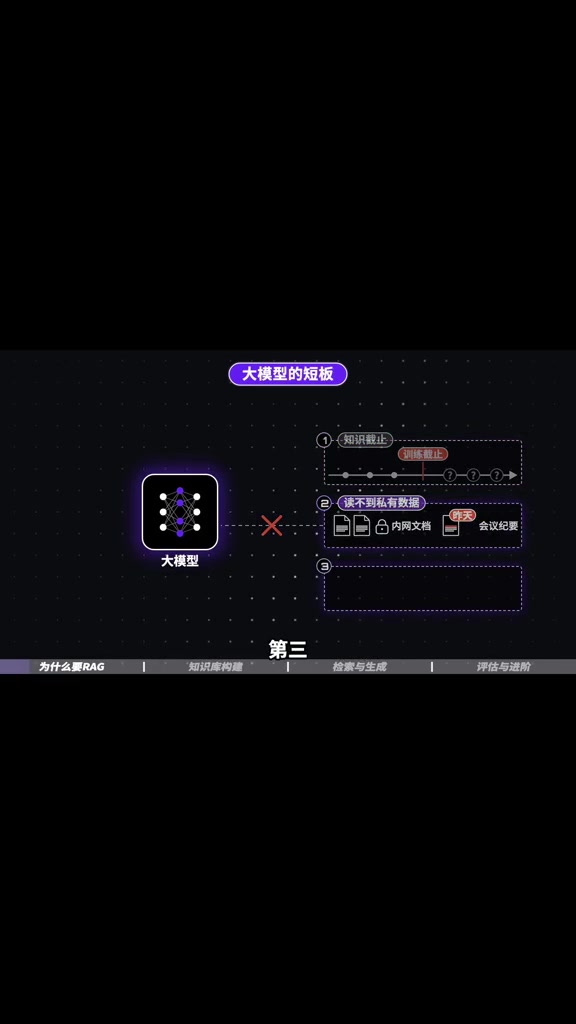
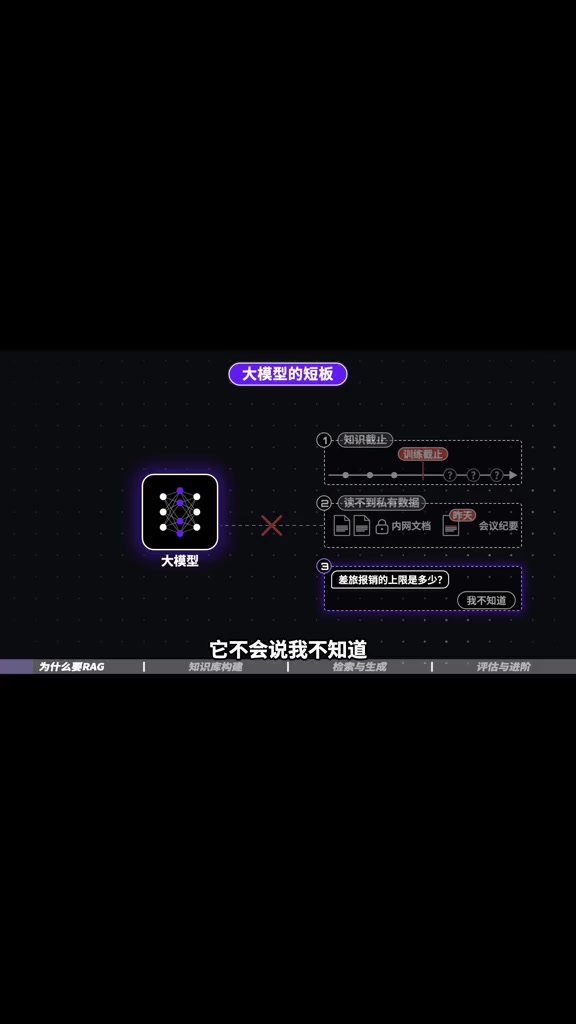
大模型本身已经非常聪明,但它有三个天生的短板:
- 训练截止——它的知识有截止日期,训练截止之后发生的事它都不知道。
- 读不到私有数据——它读不到你公司内网里的文档,也不知道你昨天刚写的会议纪要。
- 会一本正经地胡说——遇到不知道的问题,它不会说"我不知道"。
#二、为什么要 RAG
正是因为上面这三个短板,所以才需要 RAG。
RAG 的整体流程可以分为:
- 理解问题:把用户的问题先理解清楚,比如"差旅费报销标准与上限"这种原话含糊的 Query,可以先让模型改写一遍。
- 检索:从知识库里把相关内容捞出来。
- 重排:把捞到的内容重新排个序,把最相关的放前面。
- 组装:把检索结果按合适的方式拼起来。
- 生成:最后交给大模型,基于检索到的内容生成回答。
#三、回顾一下整条线
从问题出发,经过 理解 → 检索 → 重排 → 组装 → 生成 → 改写,就是一条完整的 RAG 流水线。再往深里走,就是知识库构建、检索与生成、评估与进阶。
识别 1,183 字 · 本次未扣积分 · 积分余额 1761
AI整理设置可以点此调整
内容效果不满意?点此反馈
评论
还没有评论,来说点什么吧。